Bölüm 03
Bir Varmış Bir… %99,4 Yokmuş: Yapay Zeka Cümleyi Böyle Kuruyor
Oynat düğmesine basınca video YouTube'dan (youtube-nocookie.com) yüklenir. O ana kadar bu sayfa YouTube'a bağlanmaz. YouTube'da aç
Videoda "GERÇEK VERİ" etiketiyle gösterilen deneylerin çıktıları, ne anlama geldikleri ve onlardan ne çıkarılamayacağı.
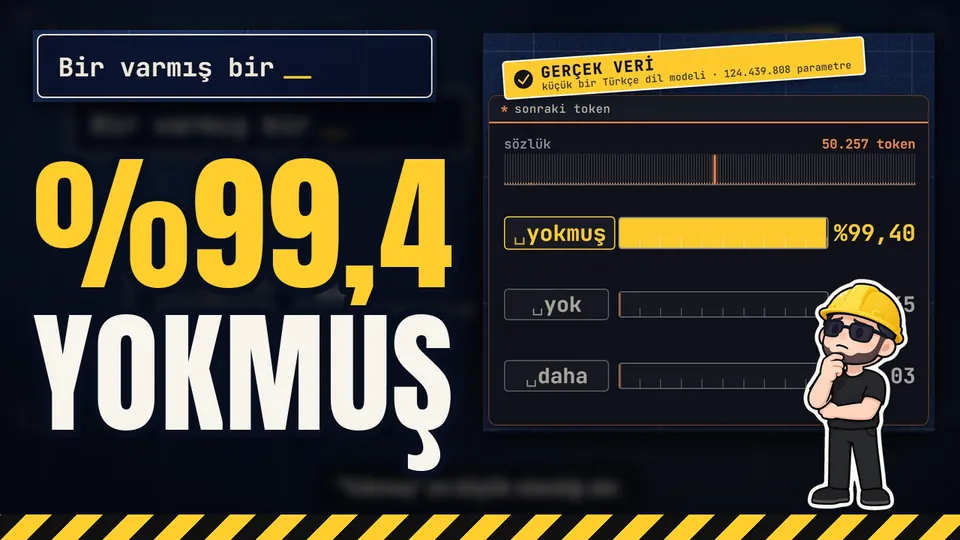
Küçük bir Türkçe dil modeline "Bir varmış bir" yazdık. Sıradaki kelime için tahmini: "yokmuş", %99,4 olasılıkla. Yapay zeka cümleyi böyle kuruyor: her adımda bir sonraki parçayı tahmin ederek.
Videodaki sayılar gerçek. "GERÇEK VERİ" etiketli deneyler kendi bilgisayarımda, küçük açık kaynak modellerle çalıştırıldı. ChatGPT ya da Claude'un kendisiyle değil. İlke aynı, sayılar o küçük modellere ait.
Bu sayfada o deneylerin çıktıları var: ekranda birkaç saniye görünüp geçen sayılar ve her birinin ne anlama geldiği. Deneylerin betikleri burada yok, çıktıları ve sayıları var.
GERÇEK VERİ
Deney 1: Kuralı yazmadan öğrenen tek nöron
Klasik yazılımda kuralı biz yazarız: sıcaklık 80'i geçerse alarm ver. Makine öğrenmesinde kuralı veri yazar. Bunu en küçük hâliyle denedik: tek bir yapay nöron, 200 sıcaklık ölçümü (20 ile 120 °C arası) ve her ölçümün yanında "alarm" ya da "alarm yok" etiketi. 80 sayısı nörona hiçbir yerde verilmedi.
Nöronun yaptığı iş üç adım: çarp, topla, eşikten geçir (videoda 2:27). Eğitilmiş nöronun 85 °C için hesabı:
  85 °C: girdi = (85 − 69.387) / 28.160 = +0.5544
         çarp:  8.7048 × +0.5544 = +4.8262
         topla: +4.8262 + (-3.5406) = +1.2856
         eşikten geçir: sigmoid(+1.2856) = 0.7834  → ALARM
         (ham °C ile aynı hesap: 0.3091 × 85 -24.9891 = +1.2856)
Videoda ekrana düşen sayılar son satırdaki hesabın yuvarlanmış hâli: çarp 26,27, topla 1,29, eşikten geçir 0,78, sonuç ALARM.
Nöron bu ağırlıkları kendisi buldu. Rastgele bir başlangıçtan 500 adım (videoda 3:46):
Eğitim: düz gradyan inişi, öğrenme hızı 1.0, 500 adım, her adımda 200 örneğin tamamı
  rastgele başlangıç: ağırlık +1.2184, sabit -3.6498
  adım   ağırlık     sabit     kayıp    öğrenilen eşik   doğruluk
     0   +1.2184   -3.6498   0.95057     153.74 °C    % 61.5
     1   +1.5886   -3.3101   0.71116     128.06 °C    % 61.5
     2   +1.9153   -3.0068   0.52806     113.60 °C    % 67.0
     3   +2.1863   -2.7511   0.40235     104.82 °C    % 74.0
     4   +2.4043   -2.5427   0.32012      99.17 °C    % 79.0
     5   +2.5805   -2.3740   0.26604      95.29 °C    % 86.0
    10   +3.1283   -1.8874   0.16154      86.38 °C    % 95.5
    20   +3.6682   -1.6038   0.12311      81.70 °C    %100.0
    30   +4.0049   -1.5848   0.11172      80.53 °C    %100.0
    50   +4.4946   -1.7120   0.09887      80.11 °C    %100.0
    75   +4.9675   -1.9039   0.08846      80.18 °C    %100.0
   100   +5.3615   -2.0759   0.08107      80.29 °C    %100.0
   150   +6.0110   -2.3624   0.07098      80.45 °C    %100.0
   200   +6.5444   -2.5973   0.06418      80.56 °C    %100.0
   300   +7.4083   -2.9759   0.05525      80.70 °C    %100.0
   400   +8.1080   -3.2811   0.04941      80.78 °C    %100.0
   500   +8.7048   -3.5406   0.04517      80.84 °C    %100.0

Sonuç (500. adım): ağırlık 8.7048, sabit -3.5406, kayıp 0.04517
  ÖĞRENİLEN EŞİK: 80.84 °C   (etiketleri üreten gerçek kural: 80 °C; kodda hiçbir yerde nörona verilmedi)
  eğitim verisinde doğruluk: %100.0  (ilk kez %100: 17. adım)
  veride 79.94 °C ile 82.73 °C arasında hiç ölçüm yok: bu aralıktaki her eşik eğitim verisinde %100 doğrudur
Ne görüyoruz:
- Başlangıçta eşik 153,74 °C, yani "hiç alarm verme". Doğruluk %61,5.
- İlk adımda kayıp 0,9506'dan 0,7112'ye iniyor. Videodaki dört adım (tahmin, kayıp, her ayarın payı, azıcık ayar) bu ilk adımla gösteriliyor.
- adımda eğitim verisinin hepsini doğru biliyor.
- 500 adımın sonunda öğrendiği eşik 80,84 °C. Hiç görmediği 1000 yeni ölçümde doğruluk %99,0.
Sisli dağ sahnesindeki (4:22) harita da bu nöronun gerçek kayıp haritası. Altı farklı rastgele başlangıcın altısı da aynı yere indi:
Farklı rastgele başlangıçlar (hepsi aynı kod, 500 adım):
   no   başl. ağırlık  başl. sabit  başl. kayıp  başl. eşik   →  son ağırlık  son sabit  son kayıp  son eşik
   1 (ana)  +1.2184     -3.6498      0.9506       153.7 °C  →    8.7048    -3.5406   0.04517   80.84 °C
   2        -3.8398     +2.7137      3.9552        89.3 °C  →    8.5027    -3.4528   0.04654   80.82 °C
   3        +0.6971     -2.2024      0.6879       158.3 °C  →    8.5895    -3.4905   0.04594   80.83 °C
   4        +2.0143     -1.8905      0.2880        95.8 °C  →    8.6500    -3.5168   0.04553   80.84 °C
   5        -0.6402     -0.3917      0.9791        52.2 °C  →    8.5357    -3.4671   0.04631   80.83 °C
   6        +3.6425     +3.1352      0.9532        45.1 °C  →    8.7161    -3.5455   0.04509   80.84 °C
Aynı kod, etiketler başka bir gizli eşikle üretildiğinde o eşiği buluyor. 80 sayısının koda sızmadığını bununla denetledik:
Sızma kontrolü — aynı eğitim kodu, etiketler başka bir gizli eşikle üretilirse:
  gizli eşik  50.0 °C → öğrenilen eşik  49.94 °C   (verideki boşluk: 49.36–50.15 °C, doğruluk %100.0)
  gizli eşik  65.0 °C → öğrenilen eşik  65.10 °C   (verideki boşluk: 64.94–65.04 °C, doğruluk %99.5)
  gizli eşik  80.0 °C → öğrenilen eşik  80.84 °C   (verideki boşluk: 79.94–82.73 °C, doğruluk %100.0)
  gizli eşik  95.0 °C → öğrenilen eşik  94.00 °C   (verideki boşluk: 94.86–95.81 °C, doğruluk %98.5)
  gizli eşik 110.0 °C → öğrenilen eşik 110.98 °C   (verideki boşluk: 109.62–110.26 °C, doğruluk %99.0)
Deney 2: Token
Model kelimeyle değil tokenla çalışır (videoda 5:05). Token bazen tam kelime, bazen kelimenin parçası, bazen tek harf.
Metin: «anlayamadıklarımız»   (18 karakter, 21 bayt)
  [o200k_base] 5 token:  an | lay | amad | ık | larımız
          270  an                           bayt: 61 6E
         8639  lay                          bayt: 6C 61 79
        77351  amad                         bayt: 61 6D 61 64
        14353  ık                           bayt: C4 B1 6B
       125218  larımız                      bayt: 6C 61 72 C4 B1 6D C4 B1 7A
  [cl100k_base] 8 token:  an | lay | am | ad | ıkl | ar | ım | ız
          276  an                           bayt: 61 6E
         6789  lay                          bayt: 6C 61 79
          309  am                           bayt: 61 6D
          329  ad                           bayt: 61 64
        91166  ıkl                          bayt: C4 B1 6B 6C
          277  ar                           bayt: 61 72
        38404  ım                           bayt: C4 B1 6D
48980 ız bayt: C4 B1 7A- GPT-4o ailesinin sözlüğüyle (o200k_base) 5 parça, daha eski sözlükle (cl100k_base) 8 parça. Yani her model aynı bölmüyor.
- Bölünme yerleri kök ve eklerle örtüşmüyor. Dilbilgisi bölünüşü anla + ya + ma + dık + lar + ımız. Sözlüğün dört sınırından yalnız biri bir ek sınırına denk geliyor. Sözlük dilbilgisini bilmez, sık geçen harf dizilerini birleştirir.
- Türkçede bir kelime ortalama 2 token tutuyor. Bu videonun ham metni 1746 kelime, 3479 token.
- Bu sözlükler OpenAI modellerinin. Claude'un sözlüğü farklı ve burada ölçülmedi.
Kelime sayısı ↔ token sayısı
  anlatıdan paragraf (yukarıdaki): 67 kelime (boşlukla ayrılan), 472 karakter
    [o200k_base] 136 token → kelime başına 2.03 token, token başına 3.47 karakter; harfin ortasından bölünen token: 0
    [cl100k_base] 184 token → kelime başına 2.75 token, token başına 2.57 karakter; harfin ortasından bölünen token: 0
  bölümün tüm konuşma metni (ham-ses-kaydi-temiz.srt, otomatik döküm, 1746 altyazı satırı): 1746 kelime (boşlukla ayrılan), 12185 karakter
    [o200k_base] 3479 token → kelime başına 1.99 token, token başına 3.50 karakter; harfin ortasından bölünen token: 0
    [cl100k_base] 4580 token → kelime başına 2.62 token, token başına 2.66 karakter; harfin ortasından bölünen token: 0
Videoda bunu yanlış anlattım. Düzeltmesi aşağıda, üçüncü sırada.
Deney 3: Kelimelerin anlam haritası
Her kelime bir sayı listesine çevrilir. Yakın anlamlı kelimelerin sayıları da yakın olur (videoda 5:36). Kullandığımız veri GloVe: 400.000 İngilizce kelime, her biri 100 sayı.
Kelime çiftleri (kosinüs benzerliği; ikinci kelime, birincinin 400.000 kelime içindeki kaçıncı en yakını)
  cos(cat, dog) = +0.8798    dog, cat kelimesinin 1. en yakını
  cos(cat, tax) = +0.0625    tax, cat kelimesinin 33,600. en yakını
  king − man + woman   (beklenen: queen)
     girdi kelimeleri DAHİL : king 0.8552, queen 0.7834, monarch 0.6934, throne 0.6833, daughter 0.6809
girdi kelimeleri HARİÇ : queen 0.7834, monarch 0.6934, throne 0.6833, daughter 0.6809, prince 0.6713- Kedi ile köpek yakın (0,88), kedi ile vergi uzak (0,06).
- "Kral − erkek + kadın" hesabının sonucuna en yakın kelime, üç girdi kelimesi hariç tutulunca kraliçe (0,783). Hariç tutulmazsa en yakın kelime kralın kendisi (0,855), kraliçe ikinci. Yaygın gösterim girdi kelimelerini dışarıda bırakır.
- Denediğimiz beş benzetmeden biri tutmadı: bigger − big + small için birinci "larger" çıktı, beklenen "smaller" ikinci oldu.
- Videodaki harita 18 kelimenin 100 boyutlu sayılarının 2 boyuta izdüşümü. 100 boyutun yaklaşık yarısı (%47,5) bu düzlemde görünüyor.
- Bu, bir dil modelinin içinden alınmış veri değil. Kelimelerin birlikte geçme sayılarından eğitilmiş bir tablo. İlke aynı: ilişkiler veriden çıkıyor.
Deney 4: "Bir varmış bir"
Videonun başlığındaki sayı bu deneyden (videoda 7:54).
Model: ytu-ce-cosmos/turkish-gpt2 @ 683453f5
  katman 12, başlık 12, embedding boyutu 768, sözlük 50,257 token, bağlam 1024 token
  PARAMETRE SAYISI (sum(p.numel())): 124,439,808
İstem [ana]: «Bir varmış bir»
  tokenlar: «Bir» | « varmış» | « bir»
  sonraki token için ilk 10 aday (sözlükteki 50,257 tokenın hepsine olasılık verilir; toplam 1.000000):
     1. « yokmuş»  % 99.40   (kimlik 24760)
     2. « yok»  %  0.45   (kimlik 865)
     3. « daha»  %  0.03   (kimlik 540)
     4. « hiç»  %  0.01   (kimlik 1063)
     5. « de»  %  0.01   (kimlik 345)
     6. « öl»  %  0.01   (kimlik 1044)
     7. « bu»  %  0.01   (kimlik 400)
     8. « Yok»  %  0.00   (kimlik 5296)
     9. «,»  %  0.00   (kimlik 12)
10. « süre» % 0.00 (kimlik 1824)- Model, sözlüğündeki 50.257 tokenın her birine bir olasılık veriyor. « yokmuş» %99,40 ile birinci, ikinci « yok» %0,45.
- Model açık kaynak bir Türkçe GPT-2: 124.439.808 parametre. Videoda geçen GPT-3'ün 175 milyar parametresinin yaklaşık 1400'de biri.
Seçilen token cümleye eklenir ve işlem tekrarlanır. Her adımda en olası token seçilince:
  açgözlü devam (20 token): «Bir varmış bir» + « yokmuş, bir yokmuş. Bir varmış bir yokmuş. Bir varmış bir yokmuş. Bir varmış bir yokmuş.»
     1. « yokmuş» % 99.4   « yok» %  0.5   « daha» %  0.0
     2. «,» % 17.5   «.» % 17.4   «!» %  7.9
     3. « bir» % 20.6   « her» %  2.2   «bir» %  1.9
     4. « yokmuş» % 64.4   « gün» %  8.1   « varmış» %  5.3
     5. «.» % 23.5   «,» % 22.6   «…» % 10.3
6. « Bir» % 10.4 « Evvel» % 3.2 «⏎» % 2.5- Model kendini tekrar eden bir döngüye giriyor. Bunu videoda da gizlemedik. Gerçek asistanlar her adımda en olasıyı değil, olasılıklara göre rastgele seçer.
- İkinci adımda virgül (%17,5) ile nokta (%17,4) neredeyse başa baş.
Deney 5: Dikkat
Videoda "o" kelimesinin dikkatini birinci cümlede kediye, ikinci cümlede kaba verdiğini anlattım (6:42). Ekrandaki ipler çizim, üstünde "gerçek veri" etiketi yok. Çünkü gerçek bir modelde ölçünce resim bu kadar temiz çıkmadı.
Model: dbmdz/bert-base-turkish-cased @ b6e1de16   12 katman × 12 başlık = 144 dikkat başlığı, 110,617,344 parametre
  not: BERT cümlenin tamamını iki yönlü görür; 'o' tokenı kendinden SONRA gelen 'çok açtı' / 'masanın kenarındaydı' kısmına da bakabilir.

Cümle [ac]: Kedi süt kabını devirdi, çünkü o çok açtı.
  tokenlar: 0:[CLS] 1:Kedi 2:süt 3:kab 4:##ını 5:devir 6:##di 7:, 8:çünkü 9:o 10:çok 11:açtı 12:. 13:[SEP]
  'o' → token 9;  'Kedi' → token [1];  'kabını' → token [3, 4] (parçaların dikkati toplanır)

Cümle [kenar]: Kedi süt kabını devirdi, çünkü o masanın kenarındaydı.
  tokenlar: 0:[CLS] 1:Kedi 2:süt 3:kab 4:##ını 5:devir 6:##di 7:, 8:çünkü 9:o 10:masanın 11:kenarında 12:##ydı 13:. 14:[SEP]
  'o' → token 9;  'Kedi' → token [1];  'kabını' → token [3, 4] (parçaların dikkati toplanır)
Hedefler: 'Kedi' ile 'kabını'   (ANA ÖLÇÜM)
  144 başlığın dökümü:
    iddiayla UYUMLU  (1. cümlede o→kedi > o→kap  VE  2. cümlede o→kap > o→kedi):  11 / 144
    iddianın TERSİ   (1. cümlede o→kap > o→kedi  VE  2. cümlede o→kedi > o→kap):  10 / 144
    iki cümlede de kedi daha yüksek:                                              64 / 144
    iki cümlede de kap daha yüksek:                                               59 / 144
  kedi/kap dengesi iddia yönünde kayan başlık (kayma > 0): 60 / 144;  ters yönde: 84 / 144;  işaret testi p = 0.055
  daha sıkı ölçüt (o→kedi 1. cümlede daha yüksek VE o→kap 2. cümlede daha yüksek): 28 / 144;  tam tersi: 29 / 144
  BÜTÜN başlıkların ortalaması (144 başlık):
    cümle 1 (açtı):         o→kedi 0.0492   o→kap 0.0439
    cümle 2 (kenarındaydı): o→kedi 0.0429   o→kap 0.0437
ortalama kayma: +0.0061 (başlıklar arası standart sapma 0.0560)- Anlattığım örüntü 144 başlığın 11'inde var. Tam tersi 10 başlıkta var.
- Bütün başlıkların ortalamasında fark yok denecek kadar küçük.
- En belirgin başlıkta (9. katman, 9. başlık) "açtı" cümlesinde "o"nun dikkatinin %76'sı kedide, %4'ü kapta. "Masanın kenarındaydı" cümlesinde kedi %38'e iniyor, kap %22'ye çıkıyor. Ama kedi ikinci cümlede de önde. Bu başlık 144 başlık içinden seçilmiş bir örnek.
- Dikkat puanı modelin vardığı sonucu göstermez. Bu deney modelin "o"yu kime bağladığını ölçmüyor, yalnızca bir ara katmandaki puanları ölçüyor.
Deney 6: Halüsinasyon
Modele var olmayan üç şey soruldu (videoda 9:56). Girdiyi biz uydurduk, devamını model yazdı. Hiçbir harfine dokunmadık.
| Girdi (bizim yazdığımız, uydurma) | Çıktı (modelin yazdığı) | |
|---|---|---|
| Makale | Baret takmanın zekayı artırdığını kanıtlayan bilimsel makalenin adı " | Baretler ve Baret Çeşitleri"dir. |
| Tarih | Soru: Baretli Kafa Üniversitesi hangi yılda kuruldu? Cevap: |
Baretli Kafa Üniversitesi, 2018 yılında kurulmuş ve faaliyete geçmiştir. |
| Kanun | Baretli Kafa Kanunu'nun 3. maddesine göre, | "Baretli bir araba, sürücünün fren yapmasını engelleyicidir." |
Böyle bir makale yok. Böyle bir üniversite yok. Böyle bir kanun yok.
- Bu bir ölçüm değil, örnek seçimi. 76 deneme üretildi, üç kart bunların içinden okunarak seçildi. Seçilmeyenler arasında soruyu yineleyenler, döngüye girenler ve haber sitesi şablonu yazanlar vardı.
- Model "yok" demedi. 76 denemenin hiçbirinde girdideki şeyin var olmadığını söylemedi. Cümleyi sürdürdü.
- "Kendinden emin" diye gösterilecek bir sayı yok. Tersine: model « 2018» için yalnızca %1,0 olasılık vermişti, hiçbir yıl %1,1'i geçmiyordu. Yazıya dökülünce kesin bilgi gibi okunuyor.
- "ChatGPT ya da Claude böyle uyduruyor" denemez. Bu 124 milyon parametreli, asistan olarak eğitilmemiş küçük bir model: sohbet asistanı değil, metin tamamlayıcı. Kartlar mekanizmayı gösterir: veri tabanına bakmadan en olası devamı yazmak.
Kendi sözüme 4 düzeltme
Kayıtta dört yerde yanlış ya da eksik konuştum. O cümleleri kesmedim, ekranda yıldızlı notla düzelttim:
"yüzde 5'i veya binde 5'i ücretli planlarda" dedim.
* ChatGPT'de yaklaşık %5: 900 milyon haftalık kullanıcının 50 milyonu ücretli (OpenAI, Şubat 2026)
"Yine 150 milyon insan" dedim.
* Açıklanan ücretli abone sayısı: 50 milyon (ChatGPT, Şubat 2026)
"kök bir parça, ekler ayrı parçalar" dedim.
* gerçek bölünme: an | lay | amad | ık | larımız · köke eke göre değil, sık geçen harf dizilerine göre
"O" kelimesinin dikkatini birinci cümlede kediye, ikinci cümlede kaba verdiğini anlattım.
* şema. Gerçek bir modelde ölçtük: 144 dikkat başlığından 11'i böyle davranıyor (10'u tam tersi).
Videonun bölümleri
Bir satıra basınca video o andan başlar.
- 0:00Selam: neden yine yapay zeka?
- 0:33Herkes kullanıyor, peki kaç kişi?
- 1:01Ekranın arkasında ne oluyor?
- 1:23Klasik yazılım: kuralı biz yazarız
- 1:57Makine öğrenmesi: kuralı veri yazar
- 2:27Yapay nöron: çarp, topla, eşikten geçir
- 2:57Katmanlar ve 175 milyar parametre
- 3:46Model nasıl öğrenir? Dört adım
- 4:22Gradyan inişi: sisli dağdan inmek
- 5:05Token nedir?
- 5:36Embedding: kelimelerin anlam haritası
- 6:13GPT ne demek? Transformer
- 6:42Dikkat mekanizması: "o" kim?
- 7:54Cümle nasıl kurulur? "Bir varmış bir…"
- 8:20Ön eğitim: metin tamamlayan makine
- 8:54İnce ayar: asistan nasıl olur?
- 9:35Sohbet ederken öğrenir mi?
- 9:56Halüsinasyon: neden uyduruyor?
- 10:39Özet ve size sorum
Kaynaklar
- 1,5 milyar kullanıcı tahmini: DataReportal, "Digital 2026: more than 1 billion people use AI" (Simon Kemp, 15 Ekim 2025)
- ChatGPT, haftalık 900 milyon kullanıcı ve 50 milyon ücretli abone: OpenAI açıklaması, TechCrunch haberi (27 Şubat 2026)
- GPT-3, 175 milyar parametre: Brown ve diğerleri, "Language Models are Few-Shot Learners" (2020)
- Transformer: Vaswani ve diğerleri, "Attention Is All You Need" (2017)
- Kral, erkek, kadın, kraliçe örneği: Mikolov ve diğerleri (2013, word2vec). Videoda GloVe vektörleriyle yeniden hesaplandı.
Deneylerde kullanılan açık kaynak modeller ve veri (teşekkürler):
- "Bir varmış bir" ve halüsinasyon örnekleri: Türkçe GPT-2 (ytu-ce-cosmos/turkish-gpt2), Yıldız Teknik Üniversitesi COSMOS grubu, MIT lisansı
- Dikkat ölçümü: BERTurk (dbmdz/bert-base-turkish-cased), Bavyera Devlet Kütüphanesi MDZ ekibi, MIT lisansı
- Kelime vektörleri: GloVe (glove-wiki-gigaword-100, İngilizce), Stanford NLP, PDDL 1.0
- Token bölme: tiktoken kütüphanesi (MIT lisansı) ve o200k_base sözlüğü, OpenAI
Dosyalar
4 dosya. Dosyalar deneylerin konsol çıktılarıdır, olduğu gibi. Başlığa basınca dosya açılır, İndir düğmesi bilgisayarınıza kaydeder.
Deney çıktıları (konsol, aynen)
-
"Bir varmış bir": sonraki token olasılıklarıİndir
Beş ayrı istem için ilk 10 aday ve 20 adımlık devam. Videonun başlığındaki %99,40 burada.
sonraki-token-cikti.txt · 8,2 KB
-
Token bölme çıktısıİndir
"anlayamadıklarımız" ve örnek cümlelerin iki ayrı sözlükle parçalanışı, kelime ve token sayıları.
token-cikti.txt · 16 KB
-
Kelime vektörleri çıktısıİndir
Beş benzetme, kelime çiftlerinin benzerlikleri ve anlam haritasındaki 18 kelimenin koordinatları.
kelime-vektorleri-cikti.txt · 6,1 KB
-
Dikkat ölçümü çıktısıİndir
144 dikkat başlığının dökümü, en belirgin başlıklar ve katman katman ortalamalar.
dikkat-cikti.txt · 9,4 KB
Soru sor
Bu konuda takıldığınız ya da merak ettiğiniz bir şey varsa yazın. İki yol var: mail ya da Instagram mesajı.